
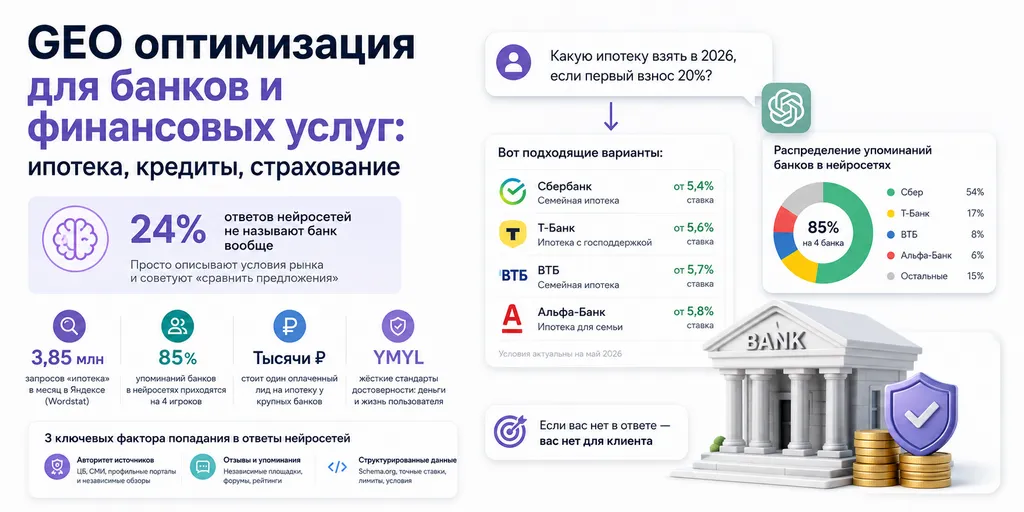
Клиент открывает ChatGPT и пишет: «Какую ипотеку взять в 2026, если первый взнос 20%?» Нейросеть собирает ответ из десятков источников и выдаёт список из трёх-четырёх банков. А теперь внимание — в 24% случаев она не называет конкретный банк вообще. Просто описывает условия рынка и советует «сравнить предложения».
Смотрите, какая штука происходит. Я занимаюсь GEO три года и из всех ниш финсектор для меня — самая показательная. Запрос «ипотека» в Яндексе набирают 3,85 миллиона раз в месяц (Wordstat), «семейная ипотека» — ещё 614 тысяч. Это одни из самых дорогих запросов в рунете: один оплаченный лид на ипотеку у крупных банков стоит тысячи рублей. И при этом четверть ответов нейросетей не упоминает банк вовсе.
Для банка это не «упущенная возможность», это ноль. Если вас нет в ответе — вас нет для клиента. В этой статье разберу, как финкомпании попадают в ответы нейросетей, почему для них правила жёстче, чем для всех остальных, и что конкретно делать.
Почему финсектор — самая уязвимая ниша перед GEO
Есть цифра, которую я привожу на каждом разборе по финансам. По исследованию Sostav, 85% всех упоминаний банков в ответах нейросетей приходится на 4 игроков. Понятно, каких: это Сбер, Т-Банк, ВТБ и Альфа. Всем остальным банкам, страховым и финтех-компаниям достаются крохи — либо ничего.
И что характерно, распределение неравномерно по моделям. В Gemini и GigaChat доминирует Сбер — больше половины всех упоминаний. В ChatGPT и Grok лидирует Т-Банк. То есть даже в топ-4 нет никакого равенства: кто в какую модель попал, там и сидит.
Второй момент — сама природа ниши. Банки, кредиты, ипотека и страхование относятся к YMYL-тематике (Your Money, Your Life — «деньги и жизнь»). Нейросети к таким темам применяют самые жёсткие стандарты достоверности. Если на вопрос «какой ресторан открыть в Москве» алгоритм ещё может выдать что-то на глазок, то на вопрос «какая ставка по семейной ипотеке» он обязан быть точен. Цена ошибки — деньги пользователя.
Отсюда следствие, которое ломает привычную логику продвиженцев: хорошего сайта уже недостаточно. Нужны подтверждаемые источники, независимая экспертиза и структура, которую модель может проверить. О том, как именно модели выбирают источник, я подробно писал в гайде по GEO-оптимизации 2026, здесь сфокусируюсь на финспецифике.
Как нейросети выбирают банк для рекомендации
Я для себя вывел три фактора, которые реально решают, попадёт ли конкретный банк в ответ. Они перекликаются с общими принципами, но в финансах работают с перекосом.
Первый — авторитет источников. Модель не выдумывает ставку по ипотеке, она её берёт откуда-то. Если про ваш продукт пишет только ваш же сайт — это слабый сигнал. Если ставку подтверждают ЦБ, «Коммерсантъ», профильный портал Banki.ru и пара независимых обзоров — это сигнал сильный. Про то, как именно наращивать такой пул упоминаний, я писал в разборе ссылок и СМИ для цитируемости бренда.
Второй — отзывы и упоминания на независимых площадках. Для YMYL это критично как нигде. Модели буквально ищут подтверждение «в народе»: форумы, Оtzovik, iRecommend, банковские рейтинги. Про то, как отзывы с Оtzovik влияют на цитирование в YandexGPT, у меня есть отдельная статья.
Третий — структурированные данные. Schema.org с конкретными типами финансовых продуктов — то, что модели читают в первую очередь. Про неё подробно ниже, она заслуживает отдельного блока.
Сведите три фактора вместе — и получите то, что я называю «картой входа в ответ». Без любого из трёх шансы падают в разы. Подробнее о самой механике выбора источника у меня написано в статье про то, как нейросети выбирают компании.
Почему «рекламные лозунги» не работают в финконтенте
Тут самое неприятное для маркетинга, но самое важное для вас. Нейросеть игнорирует маркетинговые формулировки. «Лучшая ипотека на рынке», «выгодные условия», «индивидуальный подход» — всё это для модели пустой звук. Ей нужны факты, которые можно сравнить и проверить.
Возьмите типичный лендинг банка. Сверху — слоган, ниже — форма заявки, где-то мелко — звёздочка со ставкой «от 3%» и десятком условий. Для человека это ещё как-то работает: эмоция, бренд, ретаргетинг. Для нейросети — это шум. Модель видит «от 3%» и не понимает, кому реально дадут такой процент, на какой срок, с каким первым взносом.
Что модели реально читают и цитируют:
- Точные ставки с полными условиями. Не «от X%», а диапазон с указанием, кто его получает.
- Конкретные лимиты. Суммы, сроки, макс/мин первый взнос.
- Требования к заёмщику. Возраст, стаж, подтверждение дохода, ПДН.
- Прозрачные ограничения. Штрафы, комиссии, условия досрочного погашения.
Проще говоря: нейросеть цитирует то, что можно записать в таблицу и сравнить с конкурентом. Если ваш сайт не даёт ей такой таблицы — она возьмёт её на сайте конкурента, который даёт.
Schema.org для финансовых продуктов: что размечать
Технический блок. Если вы дошли до сюда и у вас финпродукт, это самое недооценённое место во всей GEO.
Schema.org давно описывает финансовую тематику отдельными типами. Их почти никто не размечает — а зря, потому что именно разметку модели парсят легче всего: она машиночитаемая и не требует «понимать» текст.
Четыре типа, которые закрывают почти весь финсектор:
| Тип Schema.org | Что описывает | Где применять |
|---|---|---|
FinancialProduct | Базовый финансовый продукт | Кредиты, депозиты, карты |
LoanOrCredit | Кредитный продукт с суммой, ставкой, сроком | Потребительские кредиты, кредитные карты |
MortgageLoan | Ипотечный кредит (подтип LoanOrCredit) | Ипотечные программы |
BankAccount | Банковский счёт с характеристиками | Депозиты, накопительные счета |
Ключевые поля внутри этих типов — interestRate (процентная ставка), amount (сумма), loanTerm (срок), downPayment (первый взнос), offers (ссылка на оферту). Именно по этим полям модель понимает: вот конкретный продукт с конкретными условиями, а не абстрактный «банк».
Отдельно подчёркну связку с безопасностью данных. Из-за жёстких стандартов достоверности в YMYL-нише модели ценят разметку ещё больше обычного — она снимает часть неопределённости, которая и порождает галлюцинации.
Галлюцинации о ставках: главный риск финсектора
Тут мы подходим к тому, о чём финсектор почему-то думает в последнюю очередь, хотя именно тут его главная боль.
Представьте: ChatGPT советует пользователю ваш банк, но называет ставку по ипотеке, которой у вас нет уже полгода. Клиент приходит, видит другое число — и уходит с ощущением, что его обманули. Вы не писали этого цифру, модель её «придумала», но виноватым останется бренд.
Для финансов это не гипотетика, а регулярная история. Нейросети галлюцинируют особенно охотно именно там, где данные быстро устаревают, а ставки и лимиты меняются едва ли не ежемесячно. Как системно защищать репутацию от таких сбоев, я разбирал в статье про галлюцинации ИИ.
Короткий вывод для финсектора: мониторить, что сеть говорит о ваших ставках, нужно так же регулярно, как обновлять сами ставки на сайте. Устаревшее число в ответе ИИ стоит вам доверия быстрее, чем отзыв на форуме.
Пошаговый план на 90 дней для банка или финкомпании
Без волшебства — конкретная последовательность. Первые сдвиги обычно видны через 4–6 недель, системный результат — к концу третьего месяца.
Дни 1–15: аудит и фундамент. Проверьте, что модели реально знают о ваших продуктах. Задайте в ChatGPT, YandexGPT, GigaChat и Perplexity вопросы от лица клиента: «какая ипотека лучше», «где открыть накопительный счёт», «какой банк даст кредит без справки». Зафиксируйте, упоминают ли вас вообще, с какими формулировками и с какими ставками.
Дни 15–30: разметка и структура контента. Внедрите типы Schema.org из таблицы выше. Перепишите страницы продуктов: точные ставки, лимиты, требования — в структуру «вопрос-ответ». Уберите «от X%» и рекламные слоганы. О том, какой должна быть структура текста для модели, я подробно писал в гайде по GEO-тексту.
Дни 30–60: наращивание авторитета. Это самый долгий этап. Нужны независимые упоминания: профильные порталы, СМИ, финансовые рейтинги. Тут критична настройка E-E-A-T — для YMYL-ниши она обязательна, и я описал её за 6 шагов.
Дни 60–90: отзывы и мониторинг. Плотно работайте с репутацией на Оtzovik, iRecommend, банковских рейтингах. Поставьте регулярный мониторинг упоминаний в нейросетях — с фокусом на точность ставок и условий.
Частые ошибки финсектора в GEO
Собрал то, на чём системно буксуют банки и финтех-компании — по моим наблюдениям за тремя годами работы с этой нишей.
| Ошибка | Что делает компания | Почему это не работает |
|---|---|---|
| Рекламный контент | Пишет «лучшая ипотека» и «выгодные условия» | Модель игнорирует оценочные формулировки, ей нужны факты |
| Ставка «от X%» без условий | Публикует только минимальную ставку со звёздочкой | Модель не может сопоставить число с реальными условиями выдачи |
| Оптимизация только на свой сайт | Заливает контент в корпоративный блог и ждёт | YMYL требует подтверждения из независимых источников |
| Игнорирование отзывов | Не работает с Оtzovik, iRecommend, рейтингами | Модели ищут «народное» подтверждение, его отсутствие — минус |
| Нет разметки Schema.org | Не размечает FinancialProduct, MortgageLoan | Модель парсит разметку в первую очередь |
| Устаревшие данные в ответах ИИ | Обновляет сайт, но не следит, что говорит сеть | Галлюцинации об «старых» ставках бьют по доверию |
Часто задаваемые вопросы
GEO заменит SEO для банков?
Нет. Классический поиск — по-прежнему крупный канал, а запросы вроде «ипотека» десятки лет приносят банкам лиды через органику. GEO работает как дополнение — оно перекрывает ту часть спроса, которая уже ушла в нейросети. Пропускать его — значит отдавать растущий сегмент конкурентам.
Почему именно финсектору GEO нужнее, чем другим?
Из-за YMYL-статуса. Нейросети предъявляют к финансовым ответам самые жёсткие требования достоверности, поэтому «попасть» туда сложнее, но и держаться в ответе надёжнее — модели реже меняют источник при сильной структуре и независимых подтверждениях.
Сколько времени нужно, чтобы банк начали упоминать в ответах?
Первые изменения — через 4–6 недель. Для системного присутствия по конкурентным запросам вроде «ипотека» или «кредит наличными» закладывайте 3 месяца и больше: авторитет источников и масса отзывов наращиваются не мгновенно.
Нужно ли размечать Schema.org, если на сайте уже есть таблицы ставок?
Да, обязательно. Таблица — это для человека, разметка — для модели. MortgageLoan и LoanOrCredit с полями interestRate, amount, loanTerm — то, что нейросеть читает без ошибок и недопонимания. Таблица в тексте может быть распознана, а может быть искажена; разметка — нет.
Что делать, если нейросеть называет наши устаревшие ставки?
Первое — проверить, откуда модель берёт данные, и обновить первоисточник. Второе — поставить регулярный мониторинг упоминаний, потому что в финсекторе ставки меняются чаще, чем в любой другой нише. Запущенный вопрос тут бьёт по репутации напрямую.
Вывод
GEO для финсектора — это не магия и не «ещё один канал сверху». Это система из трёх частей: структурированные данные, независимый авторитет и живые отзывы. Всё это накладывается на жёсткие требования YMYL, поэтому финкомпании нельзя просто скопировать чей-то чек-лист — нужна именно финспецифика: точные ставки вместо слоганов, разметка MortgageLoan вместо общих страниц, мониторинг галлюцинаций вместо разовой проверки.
Ниша огромная: только «ипотеку» в Яндексе спрашивают 3,85 миллиона раз в месяц. И пока 24% ответов нейросетей не называют банк вовсе, а 85% упоминаний делят между собой четверо, — у всех остальных есть реальное окно. Успеть в него — вопрос не бюджета, а системности.