
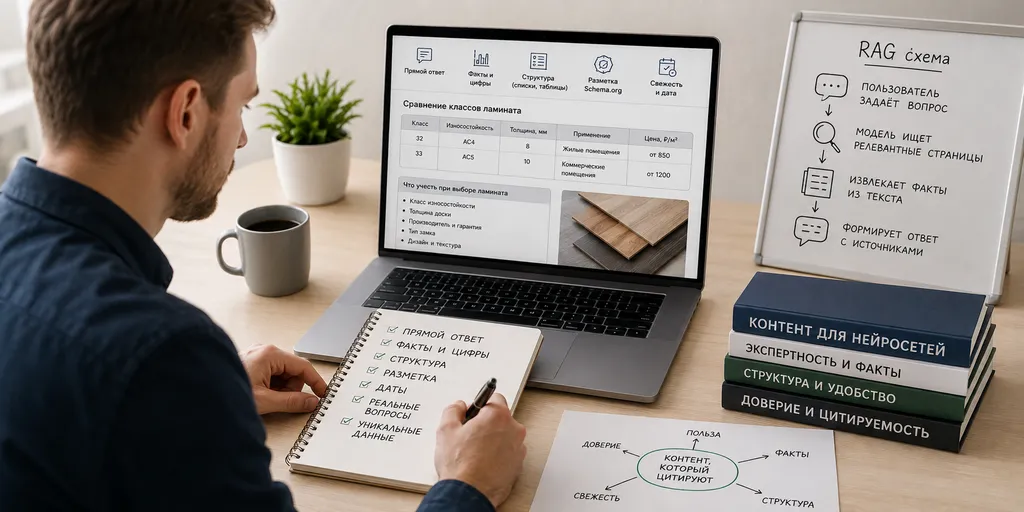
Начну с истории, которая хорошо иллюстрирует проблему. Заказчик — производитель ламината, известный бренд, приличный сайт. Мы выпустили материал «Как выбрать ламинат для квартиры»: полторы тысячи слов, экспертная подача, иллюстрации. Через месяц смотрю, что отвечают модели на этот запрос. И что вижу: ChatGPT ссылается не на нашу работу, а на страницу конкурента — два коротких абзаца и таблица классов износостойкости с ценой за метр квадратный. Клиент вне себя: «У нас же материал лучше! Почему берут их?»
Ответ простой: модель обрабатывает текст не так, как человек. И это переворачивает привычные представления о том, какой контент «хороший».
Почему модели одни страницы берут, а другие пропускают
Объясню механику без зауми. ChatGPT, Алиса, Perplexity, GigaChat не «прочитывают» сайт от корки до корки и не оценивают, насколько гладко написано. Работают они по схеме RAG: пришёл вопрос — вытащили из индекса несколько страниц — извлекли из них факты — склеили ответ.
Три фактора определяют, попадёт ли ваша страница в эти несколько:
- Релевантность вопросу. Страница обязана отвечать на вопрос теми же словами, какими его сформулировали. Если спросили «чем ламинат 32 класса отличается от 33», модель ищет текст, где эти слова стоят в связке и содержат ответ.
- Лёгкость извлечения. Модель «выжимает» из страницы числа, даты, названия, расценки. Чем больше фактов на квадратный абзац и чем аккуратнее они уложены — списки, таблицы, короткие блоки — тем выше шанс, что страницу возьмут.
- Доверие. Молодой домен без внешних ссылок уступает ресурсу, на который ссылаются, о котором упоминали, которому модель уже доверяла прежде.
Подробнее о том, как модели отбирают и «нарезают» страницы, я разбирал в отдельном разборе схемы RAG и чанкинга и в материале о том, по каким критериям нейросети выбирают компании в ответах.
И вот суть: нейросеть выбирает не самую сильную статью, а самую пригодную для «разборки». Конкурент с таблицей на два абзаца обошёл ваши полторы тысячи слов с фото лишь потому, что его страницу проще растащить на готовые куски. Обидно, но так это работает — и оборачивается в вашу пользу, если выучить правила.
Семь правил текста, который охотно цитируют
За пару лет я прогнал через нейросети сотни страниц — собственные, клиентские, чужие. Из этого опыта и сложился список. Никаких «тайных методик» — только то, что подтверждается на практике.
1. Ответ — в первых двух абзацах
Модель ищет решение вопроса, а не заход с историей компании. На запрос «чем ламинат 32 класса отличается от 33» ответ обязан быть перед глазами мгновенно: «33 класс толще и устойчивее к износу, рассчитан на коммерческие нагрузки, а 32 — для жилья». Всё, дальше можно разворачивать тему.
Проверка элементарная: откройте страницу и попробуйте отыскать ответ за пять секунд. Не вышло — не выйдет и у модели.
2. Цифры, цены, сроки, даты
Абзац без единого числа — первый кандидат на вылет. Фразы вроде «делаем качественно и быстро» модели цитируют неохотно, а вот «производство 21 день, гарантия 2 года, от 45 000 ₽» — с удовольствием, потому что это готовые данные, которые можно перенести в ответ без риска соврать.
К числам добавляйте даты: «по состоянию на июнь 2025». Свежесть источника модель оценивает, и дата служит ей ориентиром.
3. Структура: заголовки, списки, таблицы
Цельная «простыня» — самый неудачный формат для извлечения. Модель ищет готовые блоки: H2, маркированные перечисления, сравнительные таблицы. Таблица с классами ламината, характеристиками и ценами — уже почти готовый фрагмент ответа. Список «что учесть при выборе» — готовый чек-лист для читателя.
Верстайте текст так, будто его будут нарезать на цитаты. По факту так и происходит. О том, как собрать идеальную структуру текста под нейросети, есть отдельный подробный разбор.
4. Микроразметка Schema.org
Дополнительный, но весомый плюс. Разметка FAQPage, HowTo, Product сообщает модели, что на странице есть вопрос-ответ, пошаговая инструкция, товар с ценой. Google Режим ИИ и часть моделей напрямую опираются на разметку при выборе источников.
Ставится за пятнадцать минут — плагином или руками, а в ответах нейросетей порой решает исход: размеченная страница обходит неразмеченную при одинаковом контенте. Как настроить микроразметку Schema.org и JSON-LD под нейросети, разбираю пошагово в отдельном гайде.
5. Свежесть и дата обновления
Модели болезненно реагируют на даты. Статья 2021 года о ценах на ламинат их не убедит — рынок ушёл вперёд. Рецепт прост: проставляйте дату публикации и дату обновления, правьте материалы по графику, фиксируйте изменения.
Я пересматриваю ключевые посты блога раз в квартал: обновляю цифры, вношу свежие данные, ставлю новую дату. Выгода двойная — актуальность для моделей и для обычной выдачи.
6. Собственные данные и экспертиза
Пересказ чужого текста — тупик: модель возьмёт первоисточник, а не вашу копию. Нужна информация, которой нет больше ни у кого: свои исследования, замеры, кейсы с числами, небанальные сравнения.
Иллюстрация: у нас в блоге есть материал с результатами замеров упоминаний брендов по пятидесяти промптам. Такое не перескажешь из чужого — его цитируют именно потому, что он единственный в нише. Как строить контент для людей и нейросетей одновременно, чтобы он работал на извлечение, я разбирал отдельно.
7. Формулировки под настоящие вопросы
Пользователи спрашивают не так, как пишут в каталогах. «Очистка воды» против «фильтры для воды», «геодезические изыскания» против «межевание участка». Модель связывает страницу с запросом именно через формулировки.
Соберите живые вопросы: из CRM, переписок, поисковых подсказок. Вплетите их в заголовки и подзаголовки. Есть в тексте точная формулировка вопроса и ответ на неё — модель вас найдёт.
Как убедиться, что ваш контент цитируют
Написали по правилам — ещё не значит попали. Проверка нужна, и она двухступенчатая.
Первый уровень — вручную. Спустя две-три недели после публикации задайте десяток-полтора релевантных вопросов в двух-трёх нейросетях — Алисе, ChatGPT, Perplexity. Следите не только за упоминаниями бренда, но и за источниками ответов: появился ли ваш сайт в списке, откуда модель взяла факты. Источник в ответе — это уже цитирование, ранний признак. Как в принципе отслеживать упоминания бренда в нейросетях, я расписал в отдельном материале.
Второй уровень — системно. Ручками динамику не отследить: сегодня вы в источниках, завтра выпали. Поэтому я держу пул промптов в Трекере ИИ от Keys.so — инструмент по расписанию прогоняет вопросы через Алису, ChatGPT, Perplexity, GigaChat, DeepSeek, Gemini и Claude и показывает, где упоминается бренд и цитируется ли сайт. Удобно: опубликовали материал — через пару недель прогнали промпты и видите, зацепилась модель за новый контент или нет. Плюс сравнение с конкурентами по тем же запросам, без ручных таблиц.
И тут появился показатель, которого раньше не хватало. В разделе «Источники упоминаний» Трекер ИИ теперь отдельно выводит цитируемость сайта — это именно попадание вашего домена в источники ответов, а не просто упоминание бренда в тексте. Сервис показывает график с топ-источниками, таблицу с метриками видимости по каждой нейросети и отдельной строкой — цитируемость именно вашего сайта. По сути это и есть то, что я советую проверять руками («смотрите не на упоминания, а на источники»), только доведённое до автоматики: раньше ради этого приходилось вручную листать ответы, теперь цифра видна сразу.
Прочие инструменты на этом поле я сравнивал в обзоре AI-трекеров для GEO-оптимизации — полезно, если выбираете, чем мониторить цитируемость.
Сразу оговорюсь: сервис показывает «что», а не «почему». Если статья не зацепилась — причина в правилах выше: мало фактов, слабая структура, отсутствует разметка. Проверка лишь подтверждает или опровергает догадку, а чинить текст всё равно вам.
Типичные ошибки контента, который не цитируют
Собрал самые частые грабли из практики:
- «Мы лучшие» вместо фактов. Реклама не извлекается. Модель не может переложить «мы заботимся о клиентах» в ответ — и пропускает страницу.
- Сплошной текст без структуры. Две тысячи слов одним куском. Модель не нашла, за что зацепиться, — прошла мимо.
- Пересказ чужих статей. Нейросеть возьмёт оригинал. Ваш рерайт ей без надобности.
- Нет дат. Модель не понимает, свежа ли страница, и предпочитает более новые.
- Забытая разметка. Контент одинаковый, но у конкурента FAQPage стоит, у вас нет — и конкурент впереди.
- Терминология с сайта, а не из вопросов. Вы пишете «геодезические изыскания», клиент спрашивает «межевание». Модель вас не связывает.
- Текст под поисковики, а не под вопросы. Вписанные ключи и переоптимизированные заголовки нейросетям не нужны. Им нужен ответ, а не плотность вхождений.
Чек-лист перед публикацией
Прежде чем нажимать «Опубликовать», пройдитесь по списку — это пять минут:
- Прямой ответ на главный вопрос стоит в первых двух абзацах?
- В тексте есть числа, цены, сроки, даты?
- Структура на месте: H2/H3, списки, хотя бы одна таблица-сравнение?
- Микроразметка Schema.org проставлена (FAQPage, HowTo, Product)?
- Указаны даты публикации и обновления?
- Формулировки совпадают с тем, как спрашивают пользователи?
- Есть уникальные данные, которых нет у конкурентов?
Семь «да» — публикуйте и через две-три недели проверяйте источники ответов. Пять-шесть «да» — сначала подтяните слабые места.
Коротко
Нейросети цитируют не самый сильный контент, а самый удобный для извлечения: с фактами, структурой и датами. Хорошая новость — это правила, а не лотерея: поправили первые абзацы, вставили таблицу, добавили разметку — и страница уже конкурентоспособнее. Плохая — чуда не будет: контент для нейросетей надо проверять так же, как любую SEO-работу. Опубликовали, выждали, взглянули на источники ответов, докрутили. Это GEO-оптимизация контента в чистом виде — и она работает, пока вы пишете так, чтобы модели было удобно цитировать.
Часто задаваемые вопросы
Сколько текста нужно, чтобы нейросеть процитировала?
Объём — не главный критерий. Я встречал страницы на триста слов с таблицей, которые модели цитируют стабильно, и статьи на пять тысяч слов, которые они обходят стороной. Решают плотность фактов и структура: короткий текст с цифрами и таблицей пригоднее для извлечения, чем длинный без единого числа. Минимум для коммерческой страницы — прямой ответ на вопрос, три-пять фактов с цифрами и одна таблица или список. Дальше длина работает только в связке с пользой: пять тысяч слов с уникальными данными — отлично, пять тысяч слов воды — хуже, чем триста по делу.
Как часто обновлять контент?
Ключевые статьи — раз в квартал, остальные — по мере устаревания. Нейросети чувствительны к датам: страница «обновлена в июне 2025» котируется выше, чем «опубликована в 2022». При обновлении правьте числа и цены, добавляйте актуальные данные и меняйте дату — просто переставить число без правок не работает, модель этим не обмануть. Заведите график: раз в квартал пробегайтесь по главным материалам и обновляйте устаревшее. Заодно это плюс к свежести в обычном поиске — двойная выгода. Подробный разбор: как часто обновлять контент для GEO-оптимизаци
Помогает ли микроразметка?
Помогает, но это не волшебная кнопка. Разметка FAQPage, HowTo и Product — это подсказка модели, где на странице вопрос и ответ, инструкция, товар с ценой. При равном контенте размеченная страница выигрывает у неразмеченной — особенно в Google Режиме ИИ и у моделей, которые ориентируются на структурированные данные. Но если фактов на странице нет, никакая разметка не спасёт: модели нечего будет извлечь. Ставьте разметку на страницы, где уже есть ответы, списки и цены, — тогда она усилит то, что уже работает.
Чем контент для нейросетей отличается от обычного SEO-текста?
Классическое SEO пишет под поисковики: ключи, объёмы, перелинковка, мета-теги. Контент для нейросетей пишется под извлечение: прямой ответ в начале, плотность фактов, структура, по которой модель «разбирает» страницу. Разница заметна на практике: страница с идеальной плотностью ключей, но без цифр и таблиц, в выдаче ранжируется, а в ответах нейросетей не появляется. При этом одно не отменяет другого: GEO-оптимизация контента строится на том же фундаменте — индексации, авторитетности, релевантности. Просто добавляется слой «удобства для извлечения», которого в классическом SEO не было. Тонкости сравнения того, как разные модели цитируют источники, есть в разборе ЯндексGPT, ChatGPT и Perplexity.
Что делать со старыми статьями?
Не удалять — обновлять. Старая статья с актуальными данными и новой датой — это актив: у неё есть возраст, ссылочный профиль, доверие модели, которого у свежей страницы нет. Пройдитесь по архиву: где есть цифры и структура — обновите факты и дату; где сплошная вода — перепишите по правилам из этой статьи: прямой ответ в начале, таблица, разметка. Часто оживить старую статью дешевле, чем писать новую: фундамент уже проиндексирован и знаком моделям. Удалять стоит только безнадёжно устаревшее и бесполезное. Пошаговый план оживления архива — в руководстве по гео-оптимизации старых статей.
Как понять, какой контент уже цитируется?
Задайте нейросети десять-пятнадцать вопросов из своей ниши и посмотрите, откуда она берёт ответы — какие источники указывает. Ваш сайт в источниках — контент работает, копайте глубже: зафиксируйте, по каким промптам цитируют, и усиливайте именно эти страницы. В источниках конкуренты — разберите их страницы по чек-листу из этой статьи: что есть у них и нет у вас. Для системной картины я прогоняю пул промптов в Трекере ИИ от Keys.so — он показывает цитируемость сайта в источниках по расписанию, без ручной работы. Главное — смотреть не на «упомянули или нет», а на источники ответов: это и есть карта вашего цитируемого контента.
Нужны ли изображения?
Для цитирования — нет: модели извлекают текст, а не картинки. Но изображения нужны для другого: они помогают странице ранжироваться в обычном поиске, откуда нейросети и берут источники. Плюс alt-тексты с ключами добавляют релевантности. То есть картинки напрямую на цитирование не влияют, но влияют на то, попадает ли страница в поле зрения модели вообще. Мой совет: ставьте одно-два релевантных изображения на статью с осмысленным alt — и не тратьте время на стоковые фото ради красоты, они ничего не решают.