Привет. Я Сергей Язовский, пятнадцать лет в продвижении сайтов, последние три года занимаюсь GEO-оптимизацией. Это продолжение серии про ответы нейросетей. Материал получился двойной: с одной стороны обычная статья для блога, с другой — эксперимент, о котором расскажу по ходу. Проверять будем на конкретных доменах, с таблицами и датами.
Коротко ответ. Как проверить цитируемость в нейросетях: собрать 20-30 живых вопросов аудитории, прогнать их в чистых сессиях через Алису AI, ChatGPT, Perplexity и GigaChat и отметить в таблице четыре вещи. Есть ли ссылка на ваш домен, на каком месте она стоит, какая тональность у ответа и кого цитируют вместо вас.
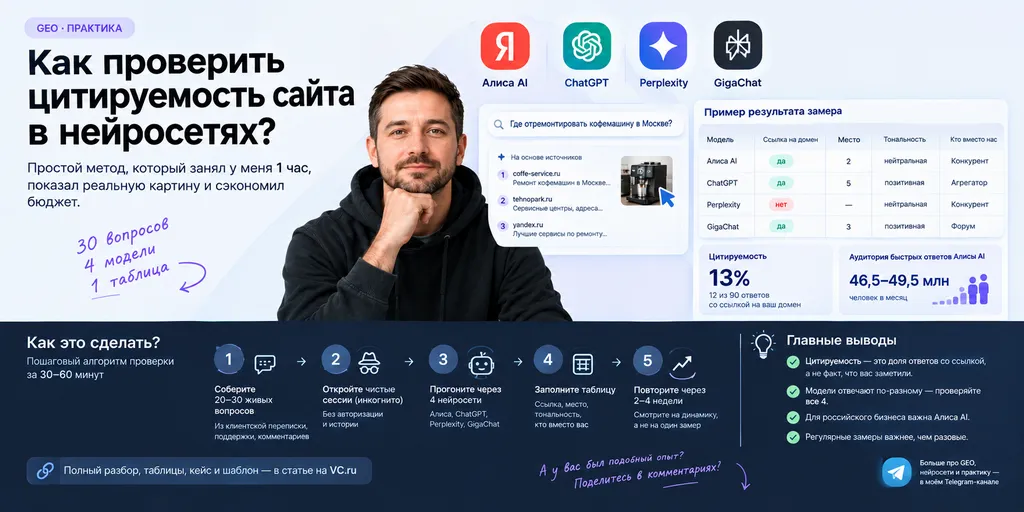
А результатом считать не галочку «нас упомянули», а долю ответов со ссылкой на ваш домен от общего числа ответов. Прогнали 30 вопросов через три модели, получили 90 ответов, в 12 из них есть ссылка на вас. Цитируемость 13 процентов. С этой цифры дальше и живут все решения.
Масштаб явления, чтобы вы понимали, с чем работаете: быстрые ответы Алисы AI по данным Яндекса используют 46,5-49,5 млн человек в месяц.
Что такое цитируемость в нейросетях
Спрос на термин выглядит странно, и по нему видно, что рынок ещё не сложился. Вордстат за последние 30 дней: «цитируемость» собирает 13 631 показ, «проверить цитируемость» — 11 896, а «цитируемость сайта» всего 90. Люди ищут старые значения слова из наукометрии и медиаизмерений. Новый смысл в запросах почти не отражён: «цитируемость сайта в нейросетях» — 31, «видимость в нейросетях» — 87, «нейроответ» — 282 показа.
Поэтому договоримся о терминах. Я различаю три уровня.
Первый уровень: модель приводит ссылку на ваш домен в источниках ответа. Это то, за что стоит бороться, потому что человек видит вас и может перейти.
Второй: вас упоминают по названию, но без ссылки. Бренд звучит в чужом ответе, трафика нет.
Третий: модель берёт ваши факты и цифры, а имя не называет. Ваш абзац поработал источником, заслуга ушла в никуда.
Рабочее определение, которым я пользуюсь: цитируемость — это доля ответов, в которых модель приводит ссылку на ваш домен, от общего числа ответов на заданный набор вопросов. Упоминания без ссылок держу отдельной строкой и в основную цифру не подмешиваю. Иначе получается красивое число, которое ничего не значит. Соседние показатели, которые стоит держать рядом, разобраны отдельно в материале про метрики GEO-оптимизации.
Почему проверка «как в SEO» тут не работает
В поиске вы смотрите на выдачу, которую сформировал алгоритм. Она одинакова для всех, пусть и с поправкой на регион. У нейросетей такой общей выдачи нет.
Один и тот же вопрос, заданный дважды, даёт разный состав источников. Позиций в привычном смысле тоже нет: модель не выстраивает сайты от первого к десятому, она выбирает фрагменты и собирает из них ответ. Сегодня ваш абзац, завтра абзац конкурента, послезавтра оба в одном ответе. Perplexity в одной сессии может показать ваш домен, а через двадцать минут при том же вопросе заменить его на профильный каталог.
Вопрос «цитируют ли нейросети мои тексты» кажется бинарным: да или нет. На практике это частота. Моя первая ошибка в этой теме, которую повторяют почти все: задать вопрос один раз, увидеть себя в источниках и закрыть задачу. Через неделю ссылки нет, и почему они ушли, непонятно. Замер — это серия, а не выстрел.
Ручной замер за 30-60 минут: пошагово
Шаг 1. Соберите 20-30 живых вопросов
Ключи из Вордстата здесь не годятся. Нужны формулировки людей: «какую лабораторию выбрать для анализов на дому», «где починить кофемашину в Москве», «какой сервис подойдёт для небольшой компании». Источники простые: переписка с клиентами, вопросы в поддержке, комментарии под статьями, подсказки Яндекса. У меня на проект уходит два подхода: сначала выписываю всё, что помню, потом чищу список до тридцати.
Шаг 2. Только чистые сессии
Инкогнито, без авторизации. История диалогов и персонализация заметно меняют состав источников. В Perplexity указывайте город прямо в тексте вопроса, иначе он уедет в Штаты и начнёт советовать американские компании.
Шаг 3. Прогоните вопросы через четыре модели
Алиса AI в поиске Яндекса, ChatGPT с включённым поиском, Perplexity, GigaChat. Минимальный набор для России. Системы ведут себя по-разному: нейроответ Алисы с блоком источников устроен не так, как отчёт Perplexity. Как каждая из моделей выбирает, кого цитировать, я разбирал в сравнительном тесте YandexGPT, ChatGPT и Perplexity.
Западные чаты не всегда сильнее. В слепом попарном сравнении модели Яндекса обошли Google AI Overviews в 56,7% случаев, это данные Яндекса за июль 2026. Для российского бизнеса Алиса часто важнее, чем весь ChatGPT вместе взятый. Механику попадания в её ответы я показывал в статье про GEO-оптимизацию под Алису.
Шаг 4. Записывайте сразу
Держите таблицу открытой и заполняйте по ходу. Через день вы не вспомните, где была ссылка, а где только упоминание. Скриншоты обязательны: ответы невоспроизводимы, и доказать потом нечего.
Шаг 5. Повторите замер
Минимум три серии с интервалом 2-4 недели. Одна серия даёт точку на графике, тенденция появляется только на третьей.
Таблица замеров: шаблон
| Вопрос | Модель | Дата | Ссылка на домен | Место в источниках | Тональность | Кто цитируется вместо нас |
Семь столбцов, ничего лишнего. Последний, про чужие имена, самый полезный: он показывает, куда двигаться. Если в источниках Perplexity одни обзоры конкурентов, вам нужны обзоры. Если Алиса ссылается на Отзовик и Профи, вам нужна работа с отзывами, а не новая статья.
Кейс: сайт поставщика промышленного оборудования
Июль 2026, компания из b2b, название не называю. Собрали 30 вопросов, прогнали через три модели, получили 90 ответов. Ссылка на домен нашлась в 7 из них, это 7,8 процента. Упоминания без ссылки — в 19 ответах. По моделям: Алиса 2, Perplexity 4, ChatGPT 1.
Что сделали за четыре недели:
- открыли сайт для AI-краулеров (один важный бот полгода стоял в запретах robots.txt);
- добавили таблицы характеристик и блоки FAQ на ключевые страницы;
- переписали вводные абзацы под короткие самодостаточные фрагменты;
- завели два внешних аккаунта, включая площадку, о которой ниже.
Второй замер, август. Ссылка в 17 ответах из 90, это 18,9 процента. Алиса 6, Perplexity 8, ChatGPT 3, упоминаний без ссылок 24. Магии в правках нет: мы убрали препятствия и дали моделям то, что они умеют извлекать.
Инструменты: чем ускорить проверку
Ручной замер бесплатный, но не масштабируется: тридцать вопросов в четырёх моделях это около часа каждые две недели. Дальше на выбор.
Точечные бесплатные проверки внутри самих сервисов дают быстрый срез по одному вопросу. Платные AI-трекеры прогоняют сотни промптов по расписанию и показывают динамику; Про класс инструментов целиком я писал в обзоре сравнение AI-трекеров.
Обычно советуют подключать трекер сразу. На практике до двух ручных замеров вы не понимаете, что показывает его отчёт: методологии у сервисов разные, цифры между собой не сходятся, и вы покупаете красивую панель без понимания, что там происходит. Сначала таблица руками, сервис потом.
Почему текст не цитируется, даже если он хороший
Причина первая и самая частая из тех, что я вижу на аудитах: краулеры не пущены. Запрет в robots.txt, правило в файрволе, агрессивная защита CDN. Разбор с проверками есть в материале про AI-краулеры и robots.txt.
Вторая: в тексте нет коротких самодостаточных фрагментов. Модель вытаскивает абзац, который сам по себе отвечает на вопрос. Как это устроено изнутри, подробно разобрано в статье про RAG и чанкинг.
Третья: вода вместо фактов. «Индивидуальный подход» и «богатый опыт» не извлекаются, потому что в них нет информации.
Четвёртая: текст лежит на площадке, закрытой для ботов. Закрытый Telegram-канал отлично работает на людей и невидим для краулеров. Это нормально, если вы это понимаете, и неприятно, если вы ждёте цитирования.
Пятая: нет структуры, по которой фрагмент легко найти. Заголовки, списки и таблицы помогают машине разобрать страницу на смысловые куски. Правила разобраны в статье про тексты под извлечение.
ТекстQ: площадка, на которой я поставил этот эксперимент
Теперь про двойное дно этого текста. Он написан как внешняя публикация для ТекстQ, молодой площадки для авторов. Я завёл там аккаунт и перенёс часть статей: интересно посмотреть, что произойдёт с цитируемостью текстов, которые живут не только на моём домене.
Что это за площадка. Авторы публикуют материалы, читатели получают внутренние монеты за активность. Экономика держится на бустах статей и комментариев, Director Mode для статьи стоит 20 монет, есть ответные статьи — механика, которая строит связки между текстами, гранты авторам, рейтинг и перенос статей из Дзена.
Заявка про AIO у них громкая. В своём материале они называют ТекстQ единственной платформой, где AIO реализован системно и на уровне 10 из 10. К таким формулировкам я отношусь ровно: это позиционирование, а не измерение. Независимых замеров, которые показали бы, что тексты с ТекстQ заметно чаще попадают в источники нейросетей, я не видел. Появится такая статистика, посмотрю первым.
А вот часть механик проверяема. Страницы открываются без авторизации, тексты живут на домене, доступном поисковым краулерам, материалы связываются друг с другом. Это условия, при которых цитируемость технически возможна. Дальше вопрос замеров, а не веры.
Что это даёт в проверке. Второй канал дистрибуции: аудитория площадки может увидеть текст, даже если ваш блог никто не заметил. Минус честно: чужой домен не ваш домен. Ссылок на ваш сайт там будет мало, в собственный трафик они не конвертируются, часть ценности уходит в брендовые упоминания.
Вывод для практики: площадка добавляет тексту второй канал жизни, но замеры не отменяет.
Чек-лист регулярной проверки
- Что мерить: долю ответов со ссылкой на домен (основная цифра), упоминания без ссылок, тональность, имена конкурентов в источниках.
- Как часто: полный прогон раз в 2-4 недели, короткий контроль по пяти вопросам раз в неделю.
- Где фиксировать: одна таблица плюс папка со скриншотами; дата и модель в каждой строке обязательны.
- С чем сравнивать: со своими же прошлыми замерами и с конкурентами, а не с чужими цифрами из отчётов агентств.
- Что проверить до первого замера: пускаете ли краулеров, извлекаются ли фрагменты, есть ли в текстах цифры.
Что не сработало
Список честный, потому что такие списки полезнее успехов.
- llms.txt. Добавили на два сайта, ничего не изменилось. Краулеры его читают, на состав источников в ответах он у меня не повлиял ни разу.
- Переписанные мета-теги. На нейроответы не влияют совсем, хотя в обычной выдаче это важно.
- Массовые упоминания бренда в комментариях и на форумах. Ни Perplexity, ни Алиса эти упоминания не подхватили. Пара часов впустую плюс вычищенный спам-след на одном ресурсе.
- Замер без даты и скриншотов. Один такой отчёт я показывал клиенту, через месяц повторить проверку не смог. Больше так не делаю.
Чего мы пока не знаем
Границы честности: часть вопросов у темы пока без ответов.
- Сколько времени проходит от публикации текста до первой ссылки. У меня разброс от двух недель до трёх месяцев, и от чего он зависит, я до конца не понимаю.
- Почему одна и та же страница стабильно попадает в Perplexity и игнорируется ChatGPT. Объяснения красивые, доказательств мало.
- Бывает, что сайт цитируют, а переходов нет. Логика «нет переходов, значит AI меня не видит» в 2026 году не работает, об этом хорошо написано у коллег в разборе про проверку видимости сайта в нейросетях.
- Отраслевого стандарта измерения нет. У каждого агентства своя формула, поэтому сравнивать чужие отчёты между собой бессмысленно.
Мои выводы
Цитируемость отвечает на вопрос «как часто», а не «заметили ли». Это доля, а не факт, и считается руками за час.
Модели отвечают по-разному, и это свойство системы, а не баг. Российский контекст недооценивать нельзя: Алиса для локального бизнеса часто важнее западных чатов.
Объём текста сам по себе не решает. Я видел, как короткая страница с таблицей обходила лонгрид в несколько раз длиннее. Значение имеют фрагменты, а не размер.
Внешние площадки вроде ТекстQ полезны как второй канал, но заявку про супер-AIO пока подкрепляют словами, а не таблицами замеров. Проверять их нужно так же, как всё остальное.
И главное: единичный замер не значит ничего. Значит только серия.
Что делать прямо сейчас
Начните с одного часа. Выпишите двадцать вопросов, откройте четыре модели в инкогнито, заполните таблицу и поставьте дату. Через две недели повторите и сравните. Если по итогам первого замера цитируемость у вас нулевая, не расстраивайтесь: так у большинства, и это лучшая точка старта, чем кажется.
Если хотите пройти этот путь вместе и посмотреть на своём проекте, приходите на консультацию — соберём вопросы и таблицу под вашу нишу.
Часто задаваемые вопросы
Как проверить цитируемость в нейросетях бесплатно?
Своими руками: список вопросов, четыре модели в инкогнито и таблица. Час работы без единого платного сервиса, пошаговая инструкция с шагами выше в статье.
Сколько вопросов нужно для честного замера?
Минимум 20, комфортно 30. В четырёх моделях это 80-120 ответов за один прогон. И каждые 2-4 недели прогон стоит повторять, иначе вы измеряете случайный день, а не цитируемость.
Чем упоминание бренда отличается от цитирования со ссылкой?
Ссылка на домен приводит людей и подтверждает, что вас выбрали источником. Упоминание без ссылки работает на узнаваемость, но кликов не приносит. Я считаю это двумя разными метриками и не смешиваю их в одну цифру.
Почему нейросеть отвечает по-разному на один и тот же вопрос?
Ответы недетерминированы: обновления модели, история диалога, включённый веб-поиск и случайность генерации меняют состав источников. Поэтому один и тот же вопрос стоит задавать несколько раз в разных сессиях и смотреть на тенденцию, а не на отдельный ответ.
Что делать, если нейросети не цитируют мой сайт?
Начните с двух проверок: пускают ли ваш сайт AI-краулеры (robots.txt, файрвол, CDN) и есть ли в текстах короткие самодостаточные фрагменты с цифрами. В большинстве случаев причина там, а не в качестве текста.
Нужен ли платный трекер для проверки цитируемости?
Не на старте. Сначала два ручных замера, чтобы понять, как выглядят ответы и что вы хотите считать. Потом трекер, когда есть с чем сравнивать и понятно, какие вопросы важно отслеживать регулярно.
Как быстро появляются первые ссылки в нейроответах?
По моим наблюдениям, от двух недель до трёх месяцев. Срок зависит от того, как часто краулеры заходят на сайт и как быстро поисковики подхватывают обновления. Ускорить процесс правками можно, предсказать до дня нельзя.
Влияет ли цитируемость в нейросетях на позиции в Яндексе?
Прямой связи никто не доказал, это разные системы. Но структура, факты и свежесть, которые помогают цитированию, работают и на обычную выдачу. Усилия не расходятся: делаете текст понятнее для модели, выигрываете и в поиске.
Можно ли попасть в ответы Алисы без SEO?
Для Алисы есть порог: она берёт источники из топ-30 обычной выдачи Яндекса. Сайт на 25-й позиции с хорошей структурой может цитироваться чаще, чем лидер без фактов, но из-за пределов тридцатки не попадёт. Классическое SEO здесь фундамент, а GEO — надстройка.
Зачем публиковать тексты на внешних площадках вроде ТекстQ, если есть свой сайт?
Второй канал дистрибуции и шанс получить упоминания за пределами своего домена. Свой блог такие площадки не заменяют: ссылки ведут на чужой домен, и часть ценности остаётся там. Смотрите на них как на дополнение, а не на замену.